整体把握这个项目
目标是亲手做出一个能识别自己手写数字的小系统,并理解每一层在做什么。先建立全景,再按 项目 Index 的六阶段流程和模块路线实践。本文给出设计与验收方向,实际代码、结果和取舍留到各模块记录。
项目先用 NumPy 手写线性分类器、梯度与训练循环,再加入隐藏层形成 MLP;随后用 PyTorch 对照相同计算。下文的 PyTorch、CNN 与 GPU 路线可以在核心闭环完成后逐步进入。
先分清训练与识别
图片在计算机里是一组像素数值。神经网络用一组可学习参数,把这些数值变成十个类别的分数;训练利用已知标签修正参数,识别则使用已经学到的参数处理新图片。
| 训练 Training | 识别 Inference | |
|---|---|---|
| 输入 | 图片 + 正确标签 | 一张新图片 |
| 主要过程 | 前向计算、损失、反向传播、更新参数 | 预处理、前向计算、选择类别 |
| 是否需要标签 | 需要,用来计算监督损失 | 不需要;评估识别是否正确时才需要 |
| 是否更新参数 | 是 | 否 |
| 输出 | 权重、训练记录、评估结果 | 预测数字与可选的类别分布 |
训练和推理共用模型结构及确定性的输入约定。推理读取选定的权重;验证负责帮助选模型,最终测试负责报告泛化表现。可结合 PyTorch 完整入门流程 阅读。
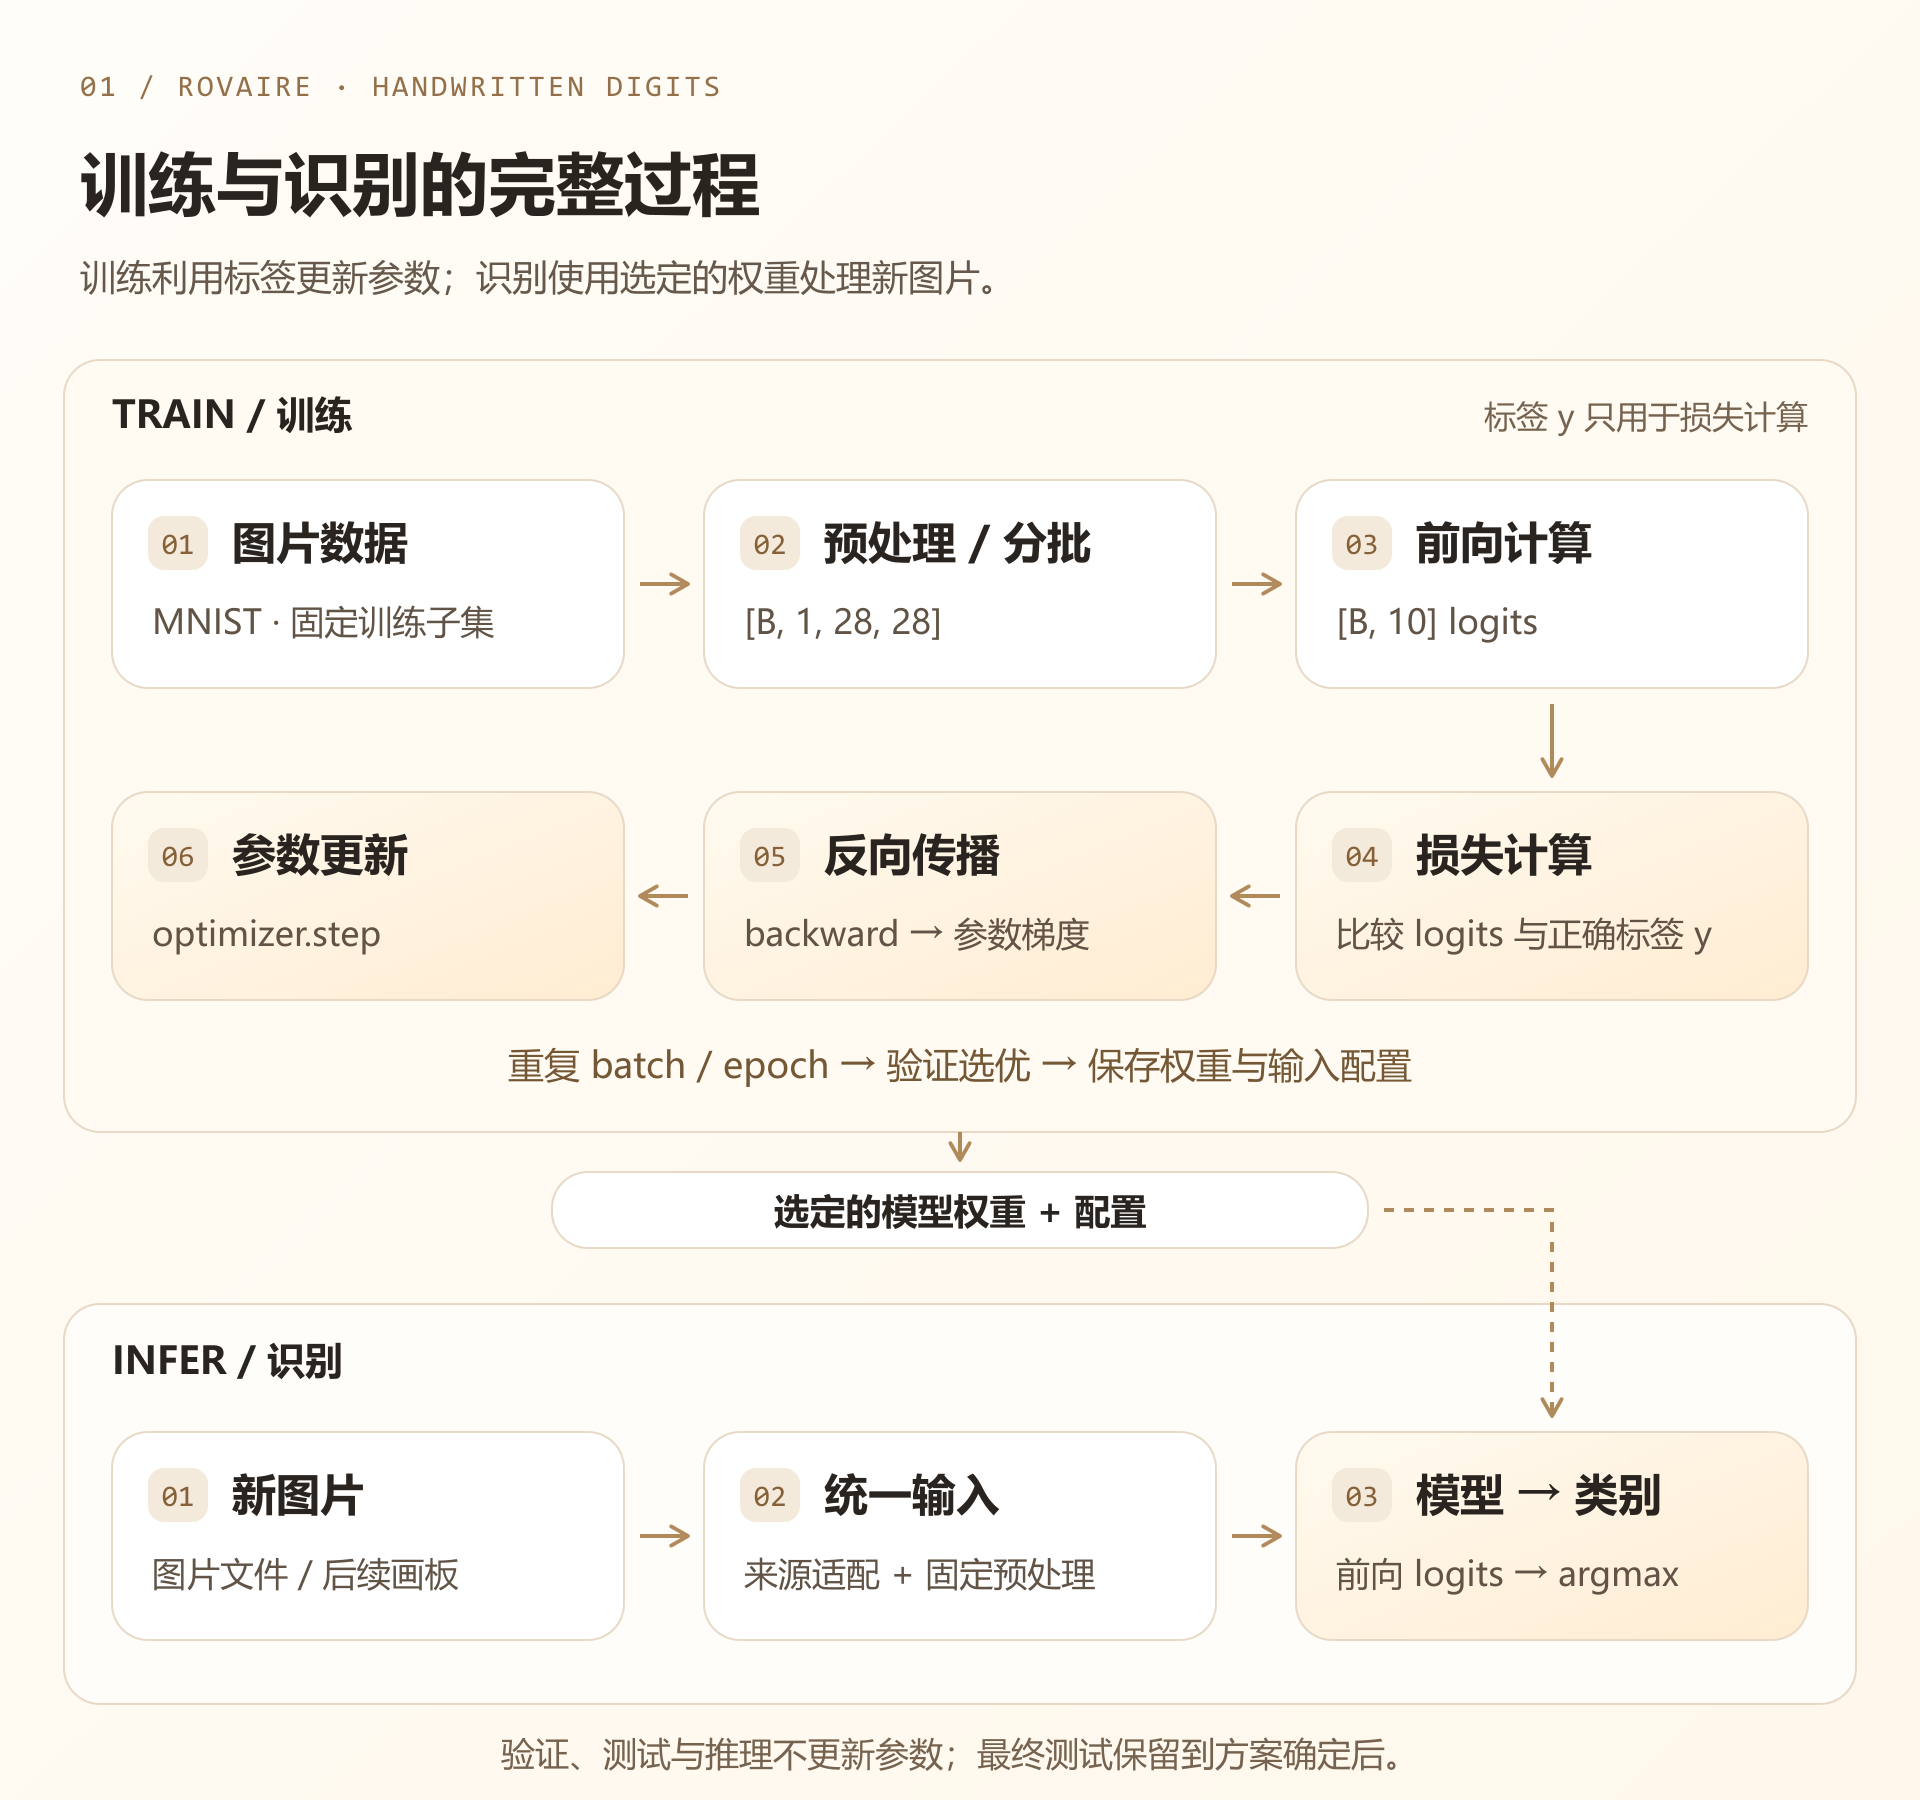
一张图片怎样被识别
假设我写了一个 7 并保存为图片,系统依次处理:
- 读取图片:解码文件,确定 RGB、灰度或透明通道;透明图先合成到明确的背景,避免直接转灰度得到意外底色。
- 统一外观:转灰度,统一成 MNIST 风格的暗背景、亮笔画;根据来源处理反色,避免对同一图片反两次。
- 整理几何形状:检查是否空白,找到有效笔画,保留纵横比缩放、补边并居中到
28 × 28。裁剪阈值、笔画占比和中心策略要记录并用图片验证。 - 构造张量:转为
float32,先把0–255缩放到0–1;如果采用标准化,再使用训练阶段固定的均值和标准差。 - 补维并放到设备:单图从
[1, 28, 28]增加 batch 维成为[1, 1, 28, 28],与模型放在同一 CPU 或 GPU 上。 - 前向计算:模型输出
[1, 10],对应0–9的原始分数,也叫 logits。 - 解释结果:沿类别维选最大分数对应的索引;想展示分布时再做 softmax,保留处理后图片方便排查。
B 表示一批图片的数量,图像张量约定为 [B, C, H, W]。本项目灰度图 C=1。Torchvision 的图像形状、整数 / 浮点范围与变换方式见 官方图像变换文档;文件读取、模式转换和缩放见 Pillow Image。
预处理要一致,但不应盲目重复处理。 MNIST 本身已经过尺寸与位置整理,自写图片需要先做来源适配;之后共用同一套确定性输入规范。训练可额外加入轻微随机平移或旋转,验证、测试和识别保持确定性。不要直接把照片随意拉伸到正方形。
单图识别是十分类问题,即使输入空白或涂鸦,普通分类器也会选出某个类别。第一版应先拦截空白输入;softmax 最大值只是模型输出的相对分布,不能直接当作“确实是这个数字”的可靠概率。
数据从哪里来,怎样分工
先用 MNIST:28 × 28 灰度数字图,标准划分为 60,000 张训练图与 10,000 张测试图。数据规格可查 MNIST 数据说明,在本项目中使用 torchvision.datasets.MNIST 加载。
建议从原训练部分再固定划分 55,000 / 5,000 张,得到:
| 集合 | 用途 | 能否据此调整方案 |
|---|---|---|
| 训练集 55,000 | 计算梯度、更新参数 | 可以 |
| 验证集 5,000 | 选结构、学习率、训练轮次和最佳权重 | 可以 |
| 原测试集 10,000 | 方案确定后作最终评估 | 不用于反复调参 |
| 自写样本 | 检查真实输入的效果和预处理问题 | 调试样本与留出的验收样本分开 |
这是一种项目划分建议。记录随机种子、具体索引和类别分布,避免重跑时偷偷换了题目。若要计算均值 / 标准差,只从训练子集计算;不要使用验证或测试集拟合预处理参数。
Dataset 定义“第 i 张图及标签是什么”,DataLoader 把样本组织成批次。训练通常打乱顺序,验证和测试通常不用打乱。对应的接口与概念见 Datasets 与 DataLoaders。
模型怎样把像素变成分数
先做便于解释的 MLP 基线:[B,1,28,28] → Flatten → [B,784] → Linear(784,128) → ReLU → Linear(128,10)。它能帮助看清矩阵乘法、偏置和非线性。
随后做小型 CNN,比较局部特征与空间结构的影响。下面是一种学习用设计,通道数和隐藏维度是可调整的选择。
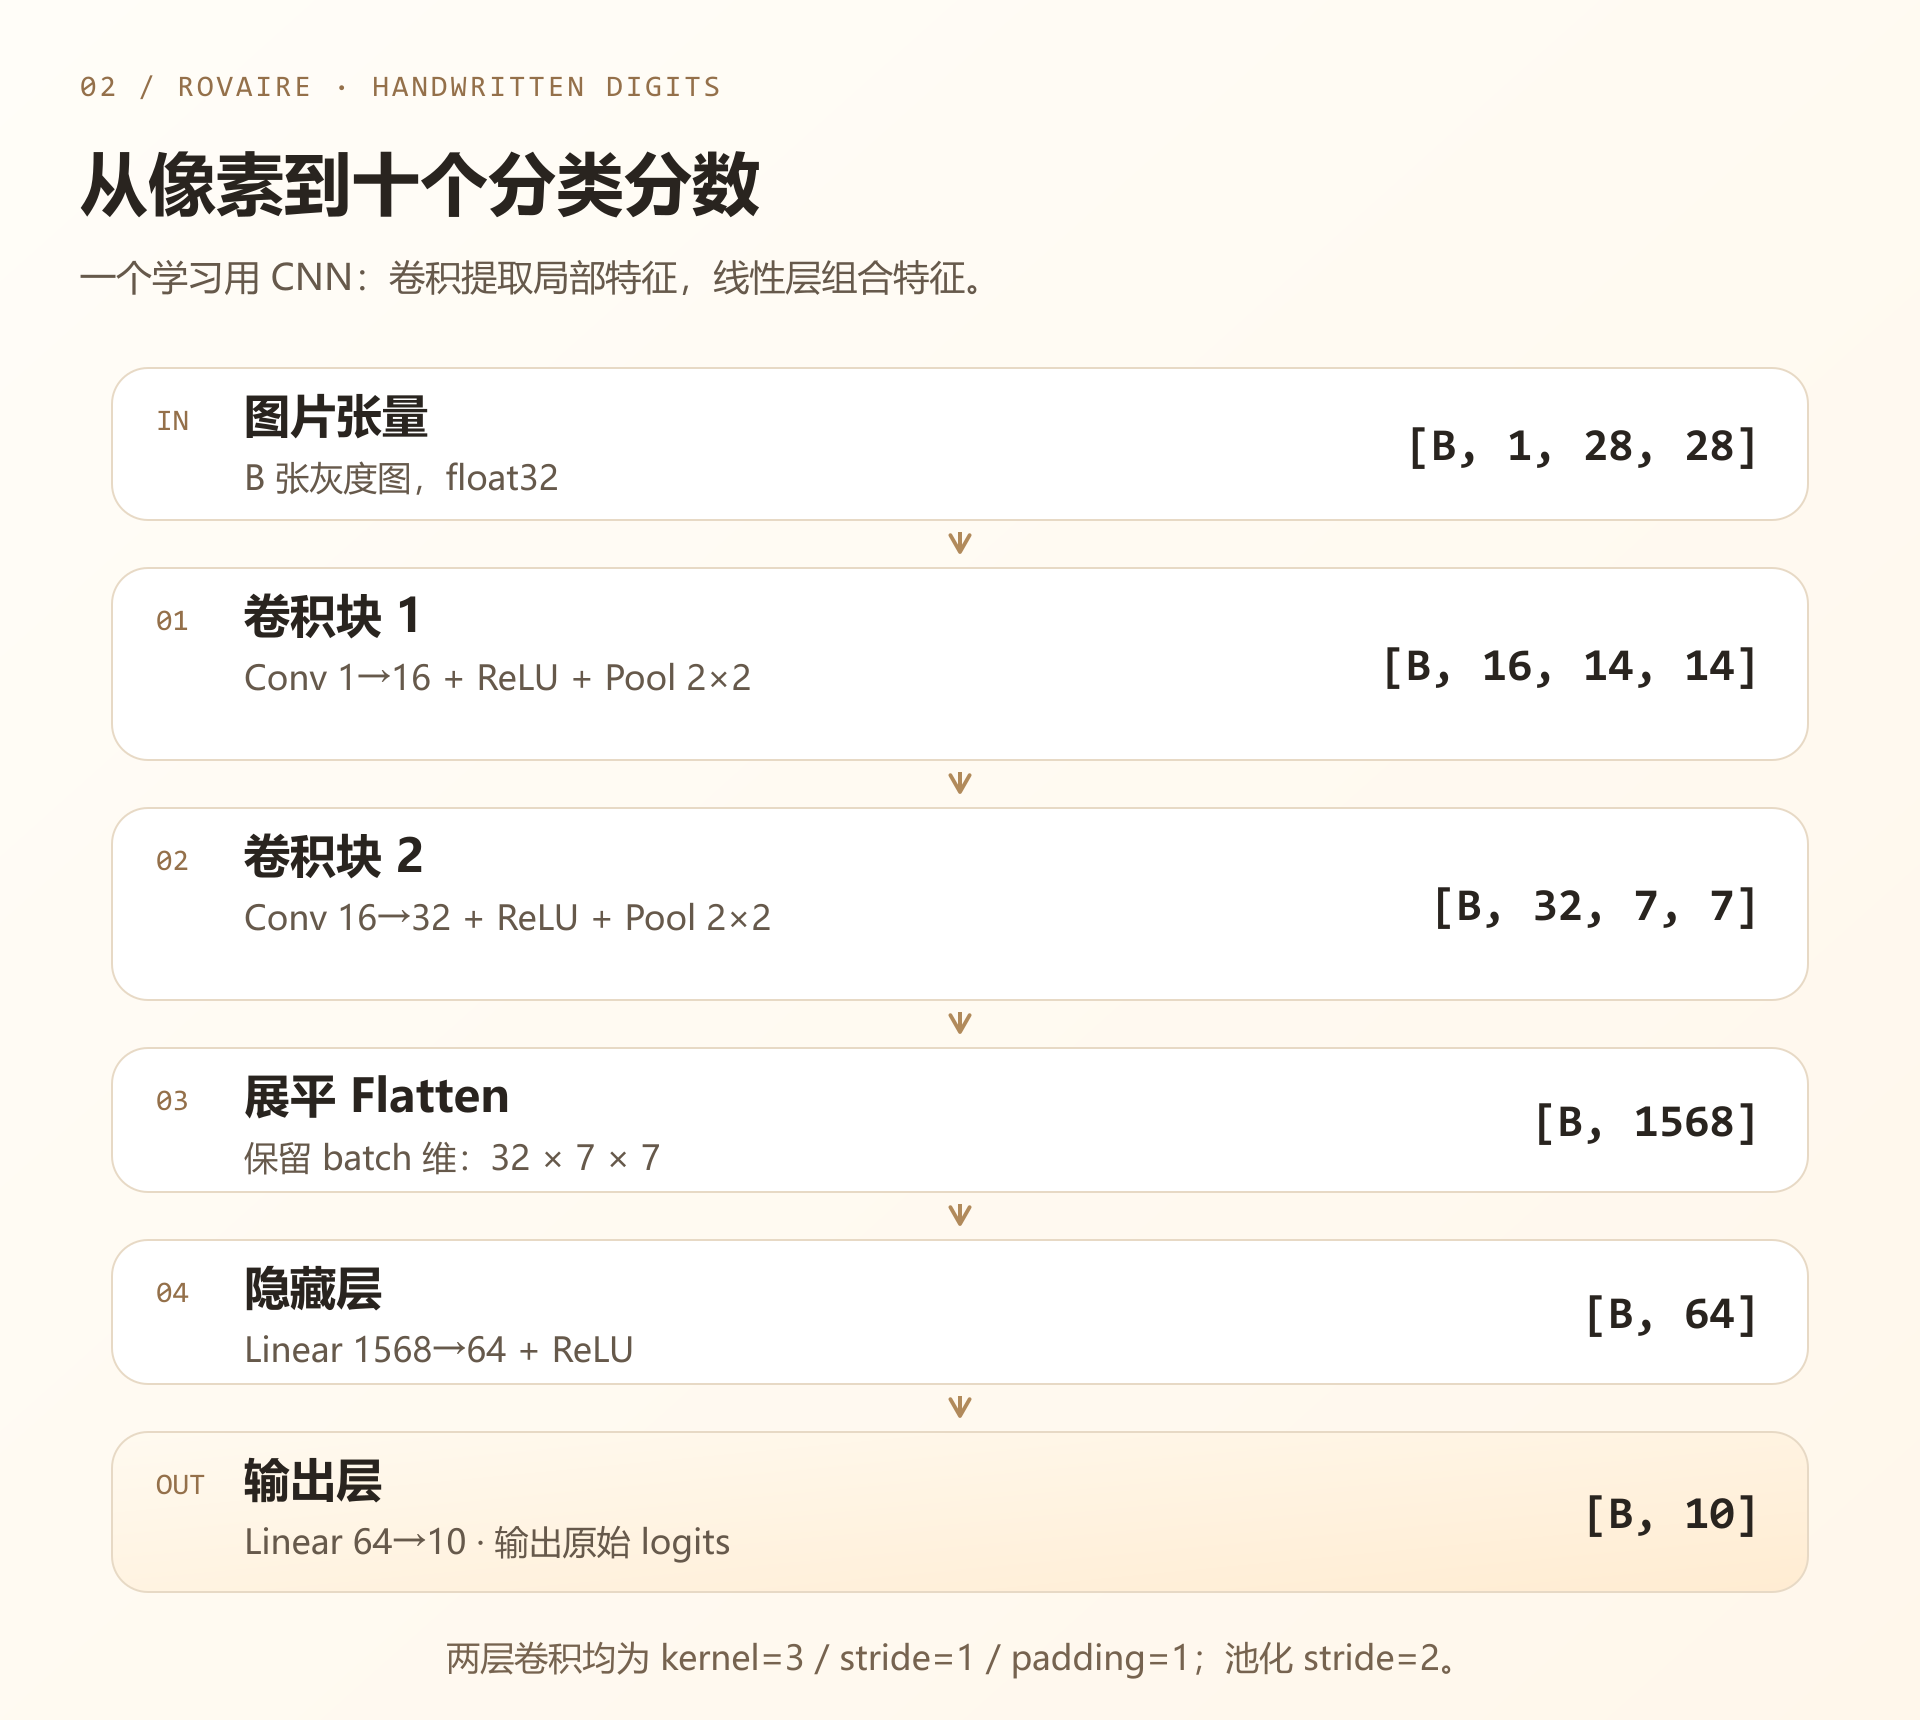
| 层 | 关键设置 | 输出形状 |
|---|---|---|
| 输入 | 灰度,28 × 28 | [B, 1, 28, 28] |
| Conv2d + ReLU | 1 → 16,kernel=3,stride=1,padding=1 | [B, 16, 28, 28] |
| MaxPool2d | kernel=2,stride=2 | [B, 16, 14, 14] |
| Conv2d + ReLU | 16 → 32,kernel=3,stride=1,padding=1 | [B, 32, 14, 14] |
| MaxPool2d | kernel=2,stride=2 | [B, 32, 7, 7] |
| Flatten | 从维度 1 开始展平 | [B, 1568] |
| Linear + ReLU | 1568 → 64 | [B, 64] |
| Linear | 64 → 10 | [B, 10] |
卷积让多个滤波器学习局部模式,ReLU 提供非线性,池化缩小空间尺寸,最后的线性层组合特征。逐层形状和参数注册可参考 构建神经网络。训练前先用假数据验证输出形状,再接入真实数据。
训练到底在改变什么
一次训练 step 处理一批数据,而一个 epoch 表示训练集走完一遍。重复读取相同图片并不等于直接记下答案:网络每次使用当前参数计算,再用误差修正参数。
每个 batch 的基本顺序:
- 清空旧梯度:上一批的梯度默认会累积,普通训练每步需要重新开始。
- 前向传播:图片
x经当前模型得到 logitsz。 - 计算损失:用正确标签
y衡量输出的偏差。 - 反向传播:
backward()按链式法则计算参数的梯度,写入.grad。 - 优化器更新:
step()根据梯度改变权重与偏置;下一批使用更新后的参数。
本项目使用整数类别标签时,CrossEntropyLoss 接收 [B,10] 的原始 logits与 [B] 的 torch.long 标签,标签取值 0–9。不要先 softmax 再传入这个损失。对一个样本,交叉熵可以写为:
接口约定见 CrossEntropyLoss。实现计算采用数值稳定的形式,不必自己直接计算指数。
梯度表示参数变化对损失的局部影响。普通 SGD 可概括为:
其中 θ 是参数,η 是学习率。Adam 等优化器还维护额外状态,不能完全用这一条更新式解释。反向传播负责算梯度,优化器负责改参数,两者是不同动作。可参考 Autograd 与 优化循环。
先挑 32–128 个固定训练样本,暂时关闭随机增强,检查模型能否把这一小组的 loss 明显压低并接近记住它们。这个实验用于查流程错误,不代表泛化能力。通过后再运行完整训练。
评估、保存与重新打开
每轮记录训练 / 验证 loss 和 accuracy;平均 loss 按样本数加权,避免最后一个较小 batch 被错误放大。对比曲线、每类表现、混淆矩阵和错分图,再决定下一步。
验证与推理时使用 model.eval(),并在 torch.no_grad() 或 torch.inference_mode() 下前向计算。eval() 切换 Dropout / BatchNorm 等层的行为,关闭梯度记录则减少计算图开销,二者作用不同。见 保存与加载模型。
保存的内容建议分两层:
- 识别包:模型
state_dict、结构配置、预处理配置、类别顺序和版本信息。权重本身并不说明图片该如何处理。 - 继续训练的 checkpoint:在上面基础上补优化器状态、epoch / step、最佳验证指标、随机状态,以及实际使用的 scheduler / scaler 状态。
按验证指标选出的最佳权重要真正落盘或复制快照,避免只保存一个随后仍会被修改的内存引用。重开一个进程,重建同样的网络、加载权重、运行同一批图片,比较输出;CPU / GPU 间允许合理浮点误差。方案确定后,再对保留的测试集出最终报告。
PyTorch 到 GPU 是怎样执行的
先以 eager 模式理解执行:Python 组织训练流程,张量算子进入 PyTorch 的 C++ 系统;Dispatcher 根据设备等 dispatch key 选择处理路径,最终调用相应 CPU 实现或 CUDA 后端。CUDA 计算可使用 cuBLAS / cuDNN 等库,也可使用专门的 kernel。相关机制见 Dispatcher 与 PyTorch C++ 前端。
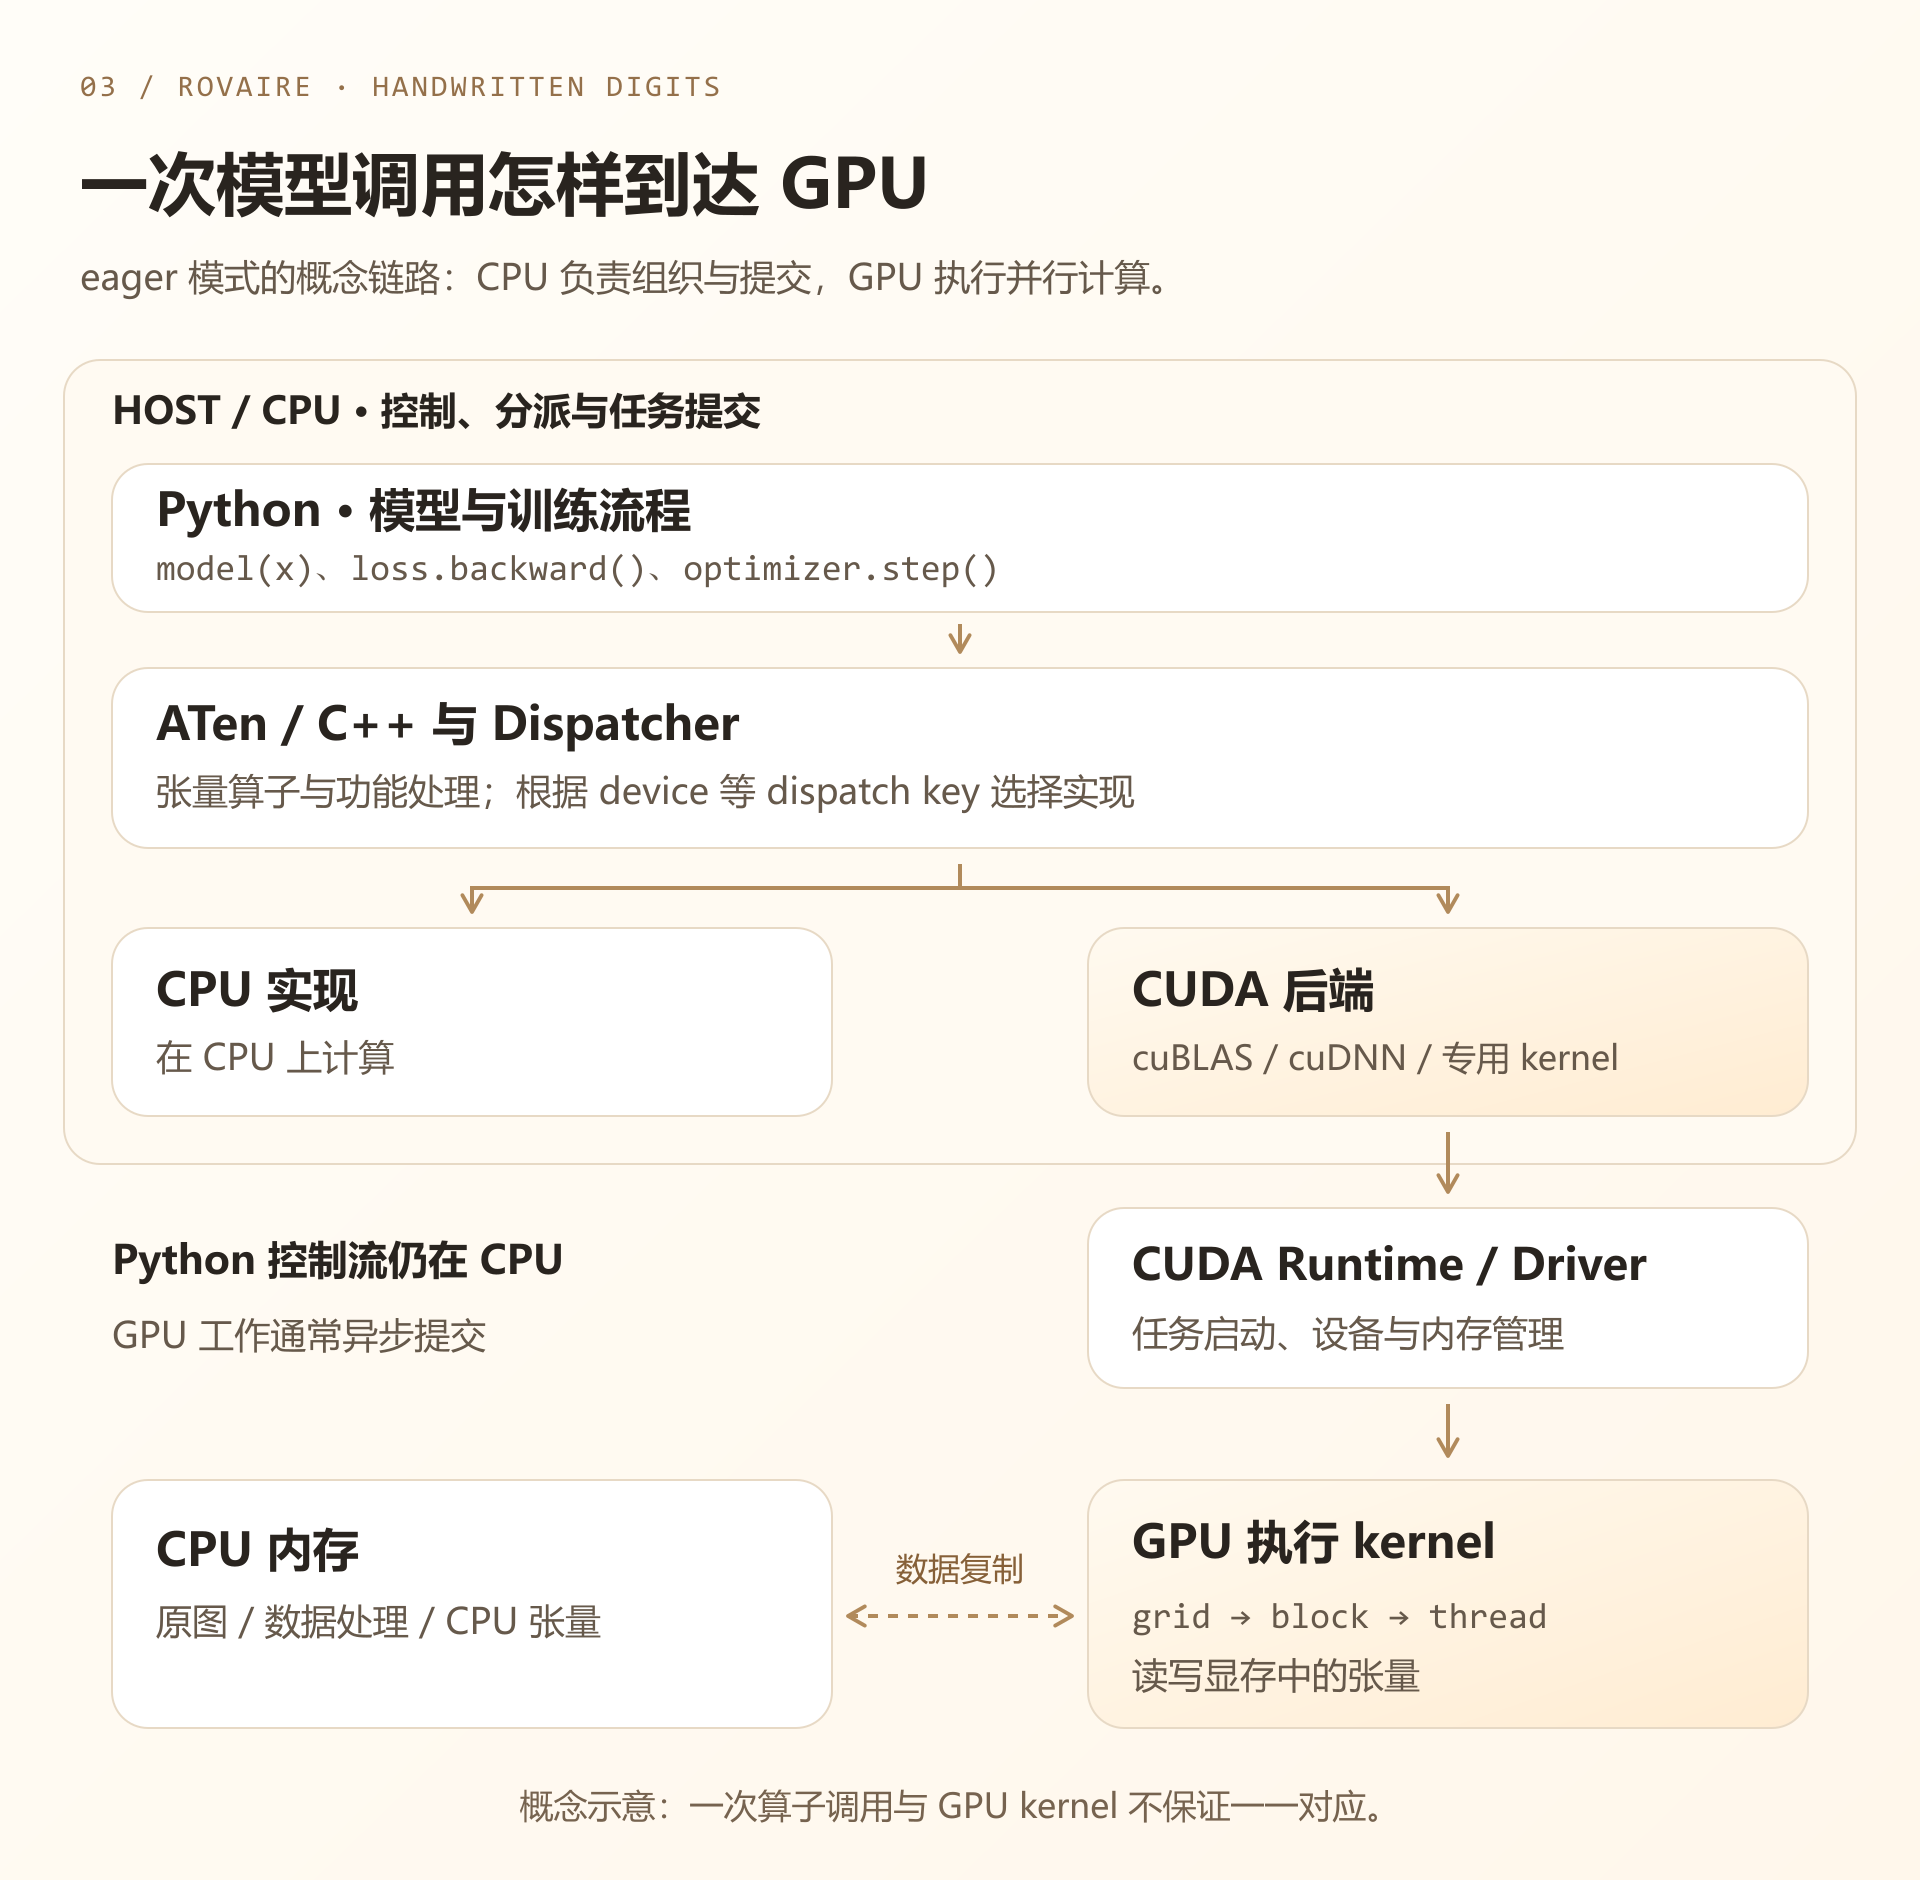
| 层 | 在这个项目里负责什么 | 可以观察什么 |
|---|---|---|
| Python | 数据迭代、模型调用、训练控制、日志 | 时间线上的读取与调用区间 |
| ATen / C++ / Dispatcher | 张量算子定义、设备与功能分派、底层实现 | aten:: 等算子事件 |
| CUDA 后端与库 | 组织 GPU 计算、选择具体实现 | kernel 启动与库调用关联 |
| CUDA Runtime / Driver | 提交任务、内存与设备管理 | launch、复制与同步事件 |
| GPU | 在显存数据上并行执行 kernel | kernel 时长、占用与数据访问 |
这是一张概念地图。一次 Python 模型调用通常包含许多算子;一个算子也可能启动多个 kernel,具体实现随版本、输入和后端而变。Autograd 记录依赖并在反向阶段调度梯度计算,它本身不等于某一个 GPU kernel。
.to('cuda') 把张量或模型参数放到设备上,不会让 Python 的循环和所有数据处理都搬到 GPU。模型、输入和损失所需标签的设备要匹配。CPU 可以训练这个项目;CUDA 路线需要兼容的 NVIDIA GPU,普通 PyTorch 使用和自己编译 CUDA 扩展的环境要求也不同。安装时按 官方选择器 选择,不预先猜版本。
GPU 工作通常异步提交。计时应预热,并使用 CUDA Event 或适当同步;分别记录纯前向时间与包含预处理 / 传输的端到端时间。MNIST 模型很小,GPU 不一定在单图场景更快。见 CUDA 执行与计时语义。
先用 torch.profiler 观察 CPU 算子、形状、内存和可用时的 CUDA kernel,再追一个具体算子。暂时沿 eager 路径建立认识;torch.compile 的捕获、融合与代码生成可以作为后续比较实验。
每个阶段用什么技术
| 阶段 | 主工具 | 要掌握的内容 | 产物 |
|---|---|---|---|
| 环境与数据 | Python、venv、torch、torchvision | 依赖版本、Dataset、DataLoader、固定划分 | 环境记录、样本网格 |
| 图片处理 | Pillow、torchvision.transforms.v2,可选 NumPy | 通道、缩放、补边、数值范围、标准化 | 处理前后对比图 |
| 模型与训练 | torch.nn、autograd、torch.optim | 前向、损失、梯度、更新 | 模型定义、训练日志 |
| 评估与可视化 | PyTorch、Matplotlib;可选 scikit-learn | 准确率、曲线、混淆矩阵、错分分析 | 评估报告、权重文件 |
| 自写数字识别 | Pillow、PyTorch;画板作为后续入口 | 共享输入规范、重载、空白检查 | 单图识别工具 |
| GPU 观察 | torch.profiler、CUDA Event | 异步、复制、算子与 kernel、批量大小 | trace、对照计时 |
| 底层实验 | C++、ATen、扩展构建工具、CUDA Toolkit | 张量内存、算子注册、线程 / block、梯度 | 一个小算子的正确性报告 |
本站的 PyTorch、NumPy、Pillow、Matplotlib 笔记可以随用随查。
C++ 的长期路线可以分两支:用 C++ 前端表达张量 / 模型,或给 Python 中的 PyTorch 注册自定义算子;它们不是必须依次经过的部署步骤。本项目优先用小算子把调用链走通,再写 CUDA 版本。扩展、训练支持及检查方式参考 自定义 C++ / CUDA 算子,GPU 编程概念参考 NVIDIA 的新版 CUDA Programming Guide。
代码职责与文件组织
下面是后续识别程序的建议结构,与本网站的文章目录分开。先建立职责边界,文件可以随自己的实现调整。
digit-recognizer/
  configs/                 模型、数据与训练配置
  src/digit_recognizer/
    data.py                数据集、固定划分与 DataLoader
    preprocess.py          图片来源适配与共享输入规范
    models/                MLP / CNN 结构
    train.py               训练 step 与 epoch 的组织
    evaluate.py            指标累计与错分分析
    predict.py             模型重载与单图识别
    artifacts.py           权重、配置与日志的保存 / 读取
  tests/                   关键输入、形状与重载等正确性检查
  data/                    原始数据和自写图片
  runs/<experiment-id>/    配置、划分索引、指标、best.pt、图表
  native/                  后期 C++ / CUDA 实验
  README.md                环境、运行方式与阶段结论
先约定几条模块之间的接口,避免把所有事情塞进一个训练文件:
| 边界 | 建议约定 |
|---|---|
| 预处理 → 数据入口 | 单样本为 [1,28,28] float32,类型与数值规范一致 |
| DataLoader → 训练 | 图片 [B,1,28,28],整数标签 [B] |
| 模型 → 损失 / 识别 | 原始 logits [B,10],类别顺序固定 |
| 训练 → 保存 | 实验配置、最佳模型快照、指标与可选续训状态 |
| 保存 → 识别 | 能重建模型与输入处理,不依赖训练进程的内存变量 |
每次实验使用独立目录,记录数据划分、结构、预处理、优化器与随机种子。可先用 JSON 配置、CSV 指标和 Matplotlib 图片,不急于引入复杂实验平台。数据、权重与 trace 属于实验产物,是否提交 Git 由大小与复现需要决定。
容易卡住的地方
| 现象 | 优先检查 |
|---|---|
| 自写图片预测很差 | 反色、笔画大小、居中、透明背景、是否重复标准化 |
| loss 不降 / 出现 NaN | 标签、学习率、输入范围、梯度是否清零、是否错误加入 softmax |
| 训练好,验证差 | 过拟合、数据分布、划分、增强与验证处理是否独立 |
| 输出维度不对 | 是否丢掉 batch 维、池化后尺寸、Flatten 起始维度 |
| 重载结果变了 | 模型配置、输入配置、是否 eval、是否加载了最佳权重 |
| GPU 更慢 / 计时奇怪 | 异步、首次初始化、batch 太小、复制开销、频繁取回标量 |
| 扩展能调用但训练不对 | 数值正确性、注册检查与梯度检查是否分别完成 |
第一次动手只做这些
- 到 01 · 环境与数据 记录本机环境,先准备 CPU 可运行的 Python 环境。
- 读取 MNIST,展示
25张图及标签。 - 打印一张图和一个 batch 的 shape、dtype、范围、device。
- 固定训练 / 验证划分,确认两边索引没有重叠。
- 写下“我现在怎样解释像素、张量、标签和 batch”,再进入预处理。
资料用于遇到问题时查阅,不要求先读完全部文档。路线的终点是能够用自己的实验解释这个系统,而每一步的证据都放回对应模块。